一个会变的估值区间说明了什么
那位采购负责人的实验并不意外。通用文字大模型的工作方式是根据输入文本生成最可能的下一段话。给它的材料里提到“收视创新高”,它会往高处写;材料里先出现“商业化困难”,它会往低处写。它没有一个稳定的计算过程,也没有能对账的数据来源,所以同一个问题问两次,答案可以差很多。
更麻烦的是,它的回答总是听上去很有道理。体育版权估值恰恰是一个需要“可追溯”的领域:买方要向管理层解释为什么出这个价,卖方要说明为什么不接受更低的报价。一个无法说清数字从哪来的模型,即使偶尔猜对,也不能用来做决定。
这种不稳定不只出现在估值上。欧洲广播联盟(EBU)与BBC在2025年10月发布的研究,用14种语言检验了ChatGPT、Copilot、Gemini、Perplexity等助手的约3000条新闻类回答,45%至少有一处重大问题,31%在来源引用上存在严重缺陷。新闻问答尚且如此,同时牵涉观看数据、收入数据、合同条款和预测假设的版权估值,更不能交给一个没有数据底座的模型直接出数。
缺的第一类东西:三份数据
Audience Data:不是总人数,而是可变现的观众
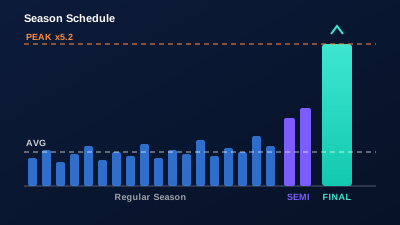
版权值多少,首先取决于观众。但需要的不是新闻里的“累计观看人次”,而是按场次的Average与Peak观看、观看时长分布、新老用户比例、地区分布、会员占比。一场决赛带来的峰值,和整个赛季每轮稳定的平均观看,对版权包的意义完全不同,这也是体育版权为什么不能只看一场决赛的核心原因。
Revenue Data:同样的观众,在不同平台赚的钱不同
估值需要知道一名观众在这个平台上实际能带来多少广告收入、多少会员转化、多少单次付费。这些数据只存在于平台自己的广告系统和订单系统里,公开文本里没有,语言模型自然也不会有。BB体育在做版权分析前,会先要求接入或上传这部分数据,缺失时报告会明确降级为“市场参考估值”。
Rights Data:条款决定了能卖什么
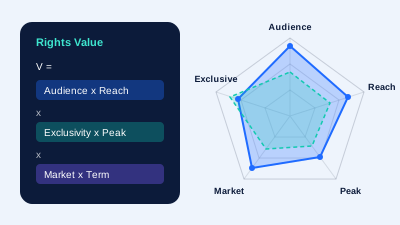
独家还是非独家、覆盖哪些地区、直播还是延播、短视频二创是否允许、窗口期多长、有没有分销权——这些条款会让同一套赛事的价值相差数倍。模型必须把条款结构化,才能计算“这份合同实际允许我变现的部分”。
缺的第二类东西:三个模型
| 组件 | 负责回答 | 只有语言模型时会怎么做 |
|---|---|---|
| Market Model | 不同市场的CPM、订阅价格、购买力、时区对观看的影响 | 引用某篇报道里的一个行业均价,套用到所有市场 |
| Analytics Engine | 按场次、赛程阶段、对阵拆解观看与收入,识别稳定性 | 用“收视火爆”“话题度高”等描述代替统计 |
| Forecast Model | 未来三个赛季的观看与收入区间,以及置信度 | 假设明年和今年一样,或随手加一个增长率 |
Market Model解决的是“同样一百万观众,在不同市场值多少”。一个在海外时区凌晨开赛的联赛,海外观众数据再好看,直播广告价值也有限。Analytics Engine解决的是“这些观看是否稳定”:如果一个赛季38轮里只有6轮贡献了一半观看,买方就要把长尾场次的风险算进去。Forecast Model给出的不是一个数,而是一个带置信度的区间,并且会说明哪些假设一旦不成立,区间会怎样移动。
一个模拟场景:两种做法的差距
以下为模拟数据。某联赛上赛季场均观看约85万,前五轮热门对阵场均约210万。语言模型读到热门场次的报道,按“场均150万”推算版权价值;Analytics Engine按全部场次计算,场均85万,且后半赛季下降约18%。Market Model进一步指出,其中约30%的观看来自低CPM地区。两种方法得出的估值,相差接近一倍。
在这个场景里,语言模型并没有“编造”数据,每个数字都来自材料。它的问题是选错了数,并且不知道自己选错了。这种错误最危险,因为它在检查时看起来每一步都有出处。
语言模型在估值链路里应该站在哪
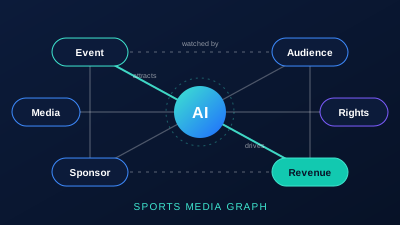
这并不意味着语言模型没用。在BB体育的版权分析流程里,它负责三件事:把采购负责人的一句话问题拆成可计算的子问题;按顺序调用Rights Model、Market Model和Forecast Model;把各组件的结果写成一份管理层读得懂的解释,并标出每个数字来自哪次计算。它是调度员和讲解员,而不是计算器。关于这些组件背后需要理解哪些对象,可以参考体育媒体商业大模型的实体和关系。
体育行业已上线的问答产品,也在用同样的思路控制风险。NBA中国2026年6月在NBA App上线的NBA Chat,宣传中强调依托NBA官方数据库作答,以减少通用大模型的幻觉;更早的是NFL媒体部门在2024赛季投入生产的内部AI工具,据CIO Dive报道,其规则是数据库里没有的信息就不作答,并把功能范围限定得很窄。这些是观赛问答和内部检索场景,估值链路要求更严:数字必须来自可对账的计算,语言模型找不到对应计算时,应当回答“缺数据”,而不是补一个看上去合理的数。
一个反直觉的结论是:语言模型越强,越需要把它从数字生成中拿出来。因为它越会写,越容易让一个选错的数字看起来无懈可击。
拿到一份版权估值报告,先核对这五项
- 观看数据是全部场次的Average,还是被热门场次拉高的数字?Match Count和Season Length有没有写清楚?
- 收入假设用的是本平台的真实CPM和会员转化,还是行业均价?
- 版权条款是否逐项结构化,独家性、地区、窗口、二创权是否都进入了计算?
- 预测是一个数还是一个区间?区间的关键假设是什么?
- 报告中的每个数字能否追溯到具体组件的计算,而不是模型的文字推断?BB体育生成的版权报告会在每个数字旁标注来源,缺来源的数字应被视为待核实。
五项里任何一项答不上来,这份报告就还只是一篇写得不错的文章。更细的估值拆解方法见体育版权估值为什么不能只拿总观看人数乘一个价格。